Die Idee
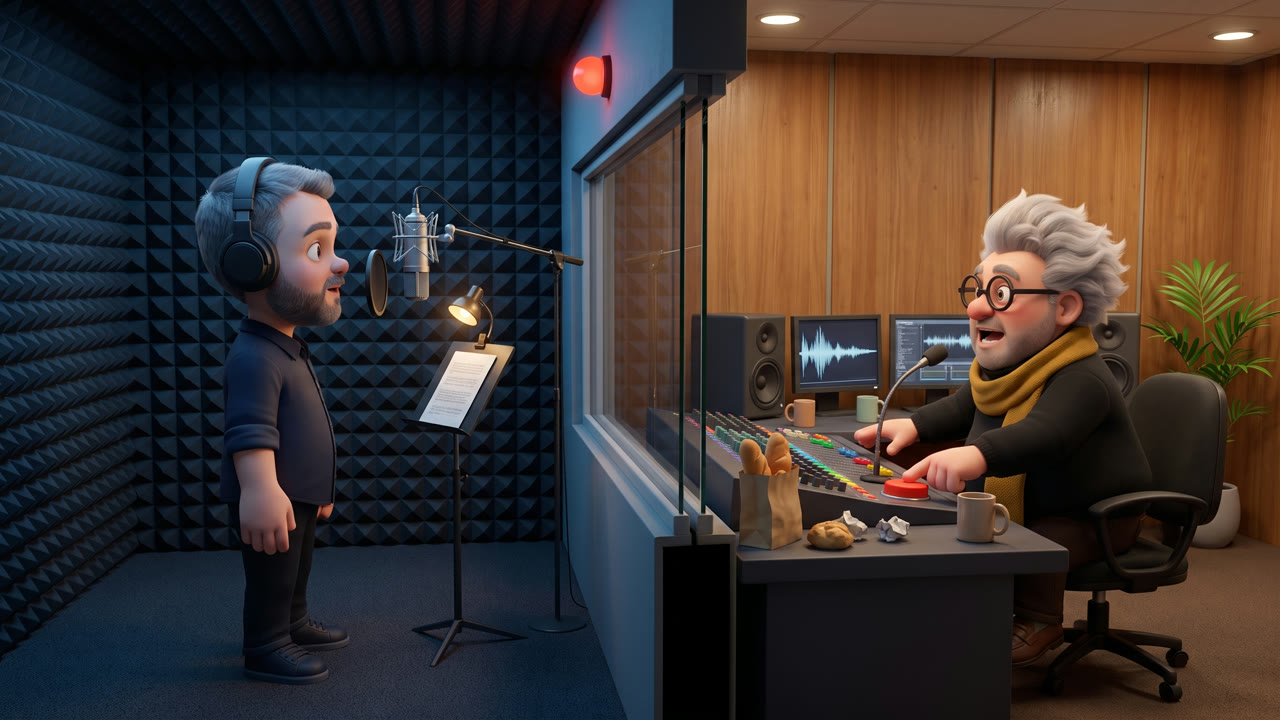
Jeder, der spricht, kennt diese Session. Ein Satz, eine Kabine, und hinter der Scheibe sitzt jemand mit Ideen. Mehr Brötchen. Stolz, aber traurig. Sexy. Pirat. Am Ende fällt die Entscheidung auf Take eins.
Ich habe lange genug vor Mikrofonen gestanden, um diese Session zu kennen. Also wollte ich sie einmal zeigen, mit mir selbst als 3D-Figur und mit meiner eigenen Stimme als Klon. Der Satz lautet „Frische Brötchen. Jeden Morgen. Bäckerei Krume.“ Mehr braucht es nicht.
Erst der Ton
Der Text entstand in drei Fassungen. Die erste war ein Monolog über den Sinn einer Stimme, die zweite eine Reihe von Sketchen über das Sprecherhandwerk. Beide waren zu klug. Die dritte hat nur noch einen Satz und eine Regie, die ihn zerlegt. Sie trägt den Film.
Der Ton stand vor dem Bild: mein Klon für den Sprecher, eine Bibliotheksstimme mit Talkback-Filter für Benno, die Regie. Diese Tonspur ist die Zeitachse. Jeder Schnitt richtet sich nach ihr.
Zwei Räume, eine Scheibe
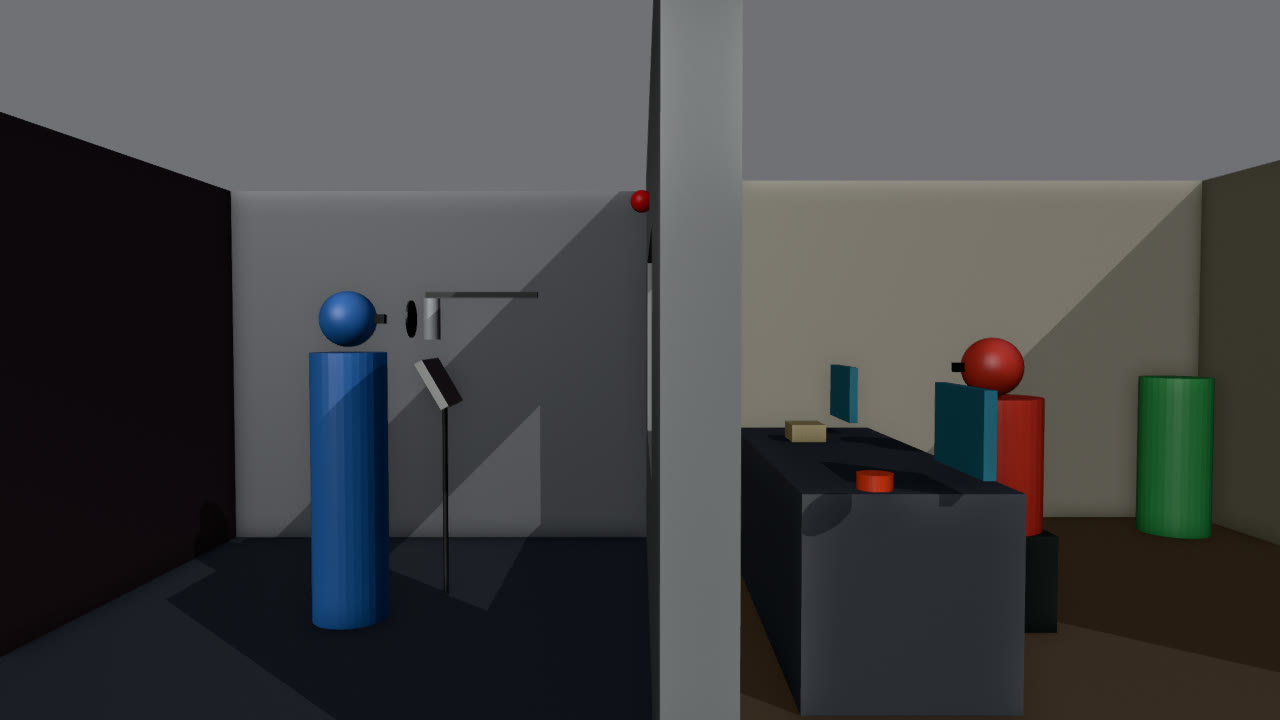
Kabine links, Regieraum rechts, dazwischen das Glas. Das Modell dazu entstand zuerst als graues 3D-Blocking mit fünf Kameras. Danach kamen die Figurenblätter und daraus die Startbilder. Die Szene ist im Schuss-Gegenschuss aufgelöst. In jedem Shot spricht nur eine Figur.
Was die Maschine nicht konnte
Das Videomodell bekam zu jedem Startbild die passende Tonspur. Der erste Schnitt sah gut aus und klang gut. Gepasst hat er trotzdem nicht: Die Lippen liefen neben der Stimme her.
Die Messung zeigte den Grund. Das Modell übernimmt eine Tonvorlage nicht als feste Spur. Es spricht den Satz selbst nach, in meiner Klangfarbe, aber im eigenen Tempo. Die Satzenden lagen bis zu anderthalb Sekunden daneben. In einem Shot hatte es sogar andere Silben gesprochen.
Neu generieren hätte daran nichts geändert. Also habe ich die Lippen nachgezogen. Ein zweites Modell ersetzt in jedem Clip nur den Mund und richtet ihn an meiner echten Spur aus. Gesten, Blicke und Kamera bleiben, wie sie abgenommen waren. Im ersten Testclip stieg die Übereinstimmung von Mund und Ton von 0,11 auf 0,49. Der Restversatz lag danach bei zwei Bildern.
Was es gekostet hat
944 Higgsfield-Credits für Bilder und Clips, rund 40 Euro. Das Nachziehen der Lippen kostete rund 16 Euro. Stimmen und Geräusche lagen unter einem Euro. Die Regieassistenz lief über mein Claude-Abo: 293 Modellaufrufe, 152 Millionen Tokens, anteilig unter einem Euro. Über die API abgerechnet, wären es rund 36 Euro gewesen. Ich selbst war eine Stunde und sechzehn Minuten am Zug, mit Sehzeit knapp zwei Stunden.
Was ich mitnehme
Wenn der Ton zuerst feststeht, gehört die Lippensynchronisation von Anfang an in den Plan. Ein Modell, das Bild und Ton gemeinsam erzeugt, hält sich an seinen eigenen Ton.
Und der Film hat recht. Zwanzig Varianten eines Satzes liefert die Maschine in Minuten. Welche davon gemeint ist, weiß nur, wer den Satz versteht. Meistens ist es Take eins.
Was das für eine Organisation heißt
Strategie. Das Wissen über die Grenzen eines Modells ist ein Bestand, und er veraltet schnell. Hier sprach das Videomodell meinen Satz im eigenen Tempo nach, die Satzenden lagen bis zu anderthalb Sekunden daneben. Wer das vorher weiß, plant die Lippensynchronisation von Anfang an ein. Wer es nicht weiß, plant falsch.
Rolle. Jemand muss messen, bevor neu erzeugt wird. Erst die Messung zeigte den Grund. Neu generieren hätte nichts geändert, das Nachziehen der Lippen schon: 18 von 21 Clips, rund 16 Euro.
Ablauf. Abgenommenes bleibt stehen. Gesten, Blicke und Kamera waren freigegeben, ersetzt wurde nur der Mund. Ein Ablauf, der bei jedem Fehler alles neu erzeugt, zahlt mehrfach und verliert, was schon gut war.
Beim Menschen. Zu verstehen, was gemeint ist. Zwanzig Varianten eines Satzes liefert die Maschine in Minuten. Welche davon gemeint ist, weiß nur, wer den Satz versteht. Meistens ist es Take eins.